GPT-OSS Swallow 120B RL v0.1 の MXFP4 版を llama.cpp の llama-server で動かす技術検証で、公式の safetensors から自分で GGUF に変換しようとしたところ、変換器が assert で止まりました。元の gpt-oss(OpenAI の MXFP4 版)が通る形を前提にした変換器なので、同じ系統のモデルでなぜ落ちるのかで迷うところです。
結論
- 原因は MoE の量子化ブロックの形です。 Swallow 版は、名前が
_blocksで終わるテンソルを[専門家, 行, 1440]の3次元で持っています。llama.cpp の変換器(conversion/gpt_oss.pyのrepack_mxfp4)は OpenAI の元の形[専門家, 行, 90, 16]を前提にしていて、assert len(blocks.shape) == 4で落ちます。 - 並びは同じ(行優先で 1440 = 90 × 16)なので、形を戻すだけで済みます。
- llama.cpp のソースは書き換えず、
GptOssModel.get_tensorsを包んで3次元のブロックだけ4次元に reshape するラッパーから変換器を走らせました。4 分 58 秒・RSS 4.9 GiB で通りました。
試した環境
- モデル: tokyotech-llm/GPT-OSS-Swallow-120B-RL-v0.1-MXFP4(リビジョンを固定して取得。61 GB、取得に 9 分)
- 変換器: llama.cpp v0.6.0 の
convert_hf_to_gguf.py - 変換用の venv: llama.cpp の requirements のとおり(torch は CPU 版 2.11.0)
- 変換したマシン: Ubuntu。変換に GPU は使いません
何が起きたか
変換器をそのまま走らせると、repack_mxfp4 の中の次の行で落ちました。
assert len(blocks.shape) == 4トレースバックの全文は残していませんが、落ちたのはこの assert で、関数は repack_mxfp4 です。
Swallow 版のブロックは3次元で、最後の次元が 1440 でした。元の gpt-oss は同じブロックを [専門家, 行, 90, 16] の4次元で持っていて、90 × 16 = 1440 です。最後の2つの次元が、1つにまとまっていたわけです。
なぜ形を戻すだけでよいのか
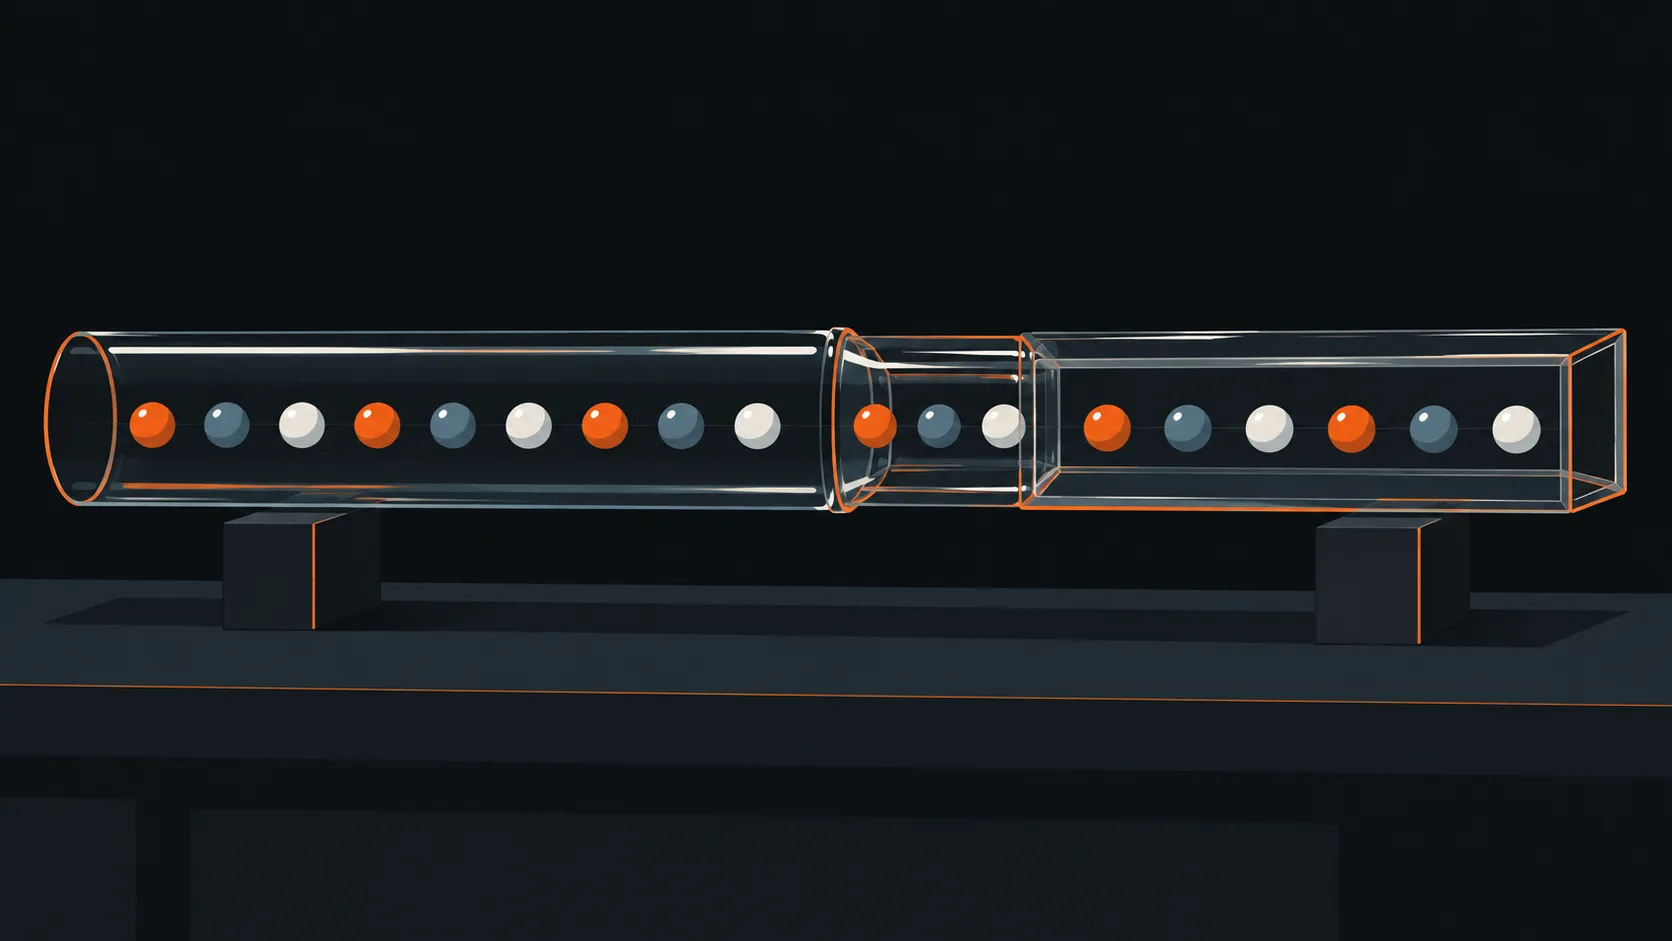
行優先で並んでいれば、[専門家, 行, 1440] と [専門家, 行, 90, 16] は中身の並びが同じです。最後の 1440 個を 16 個ずつ 90 組に区切り直すだけなので、値を並べ替える必要はありません。
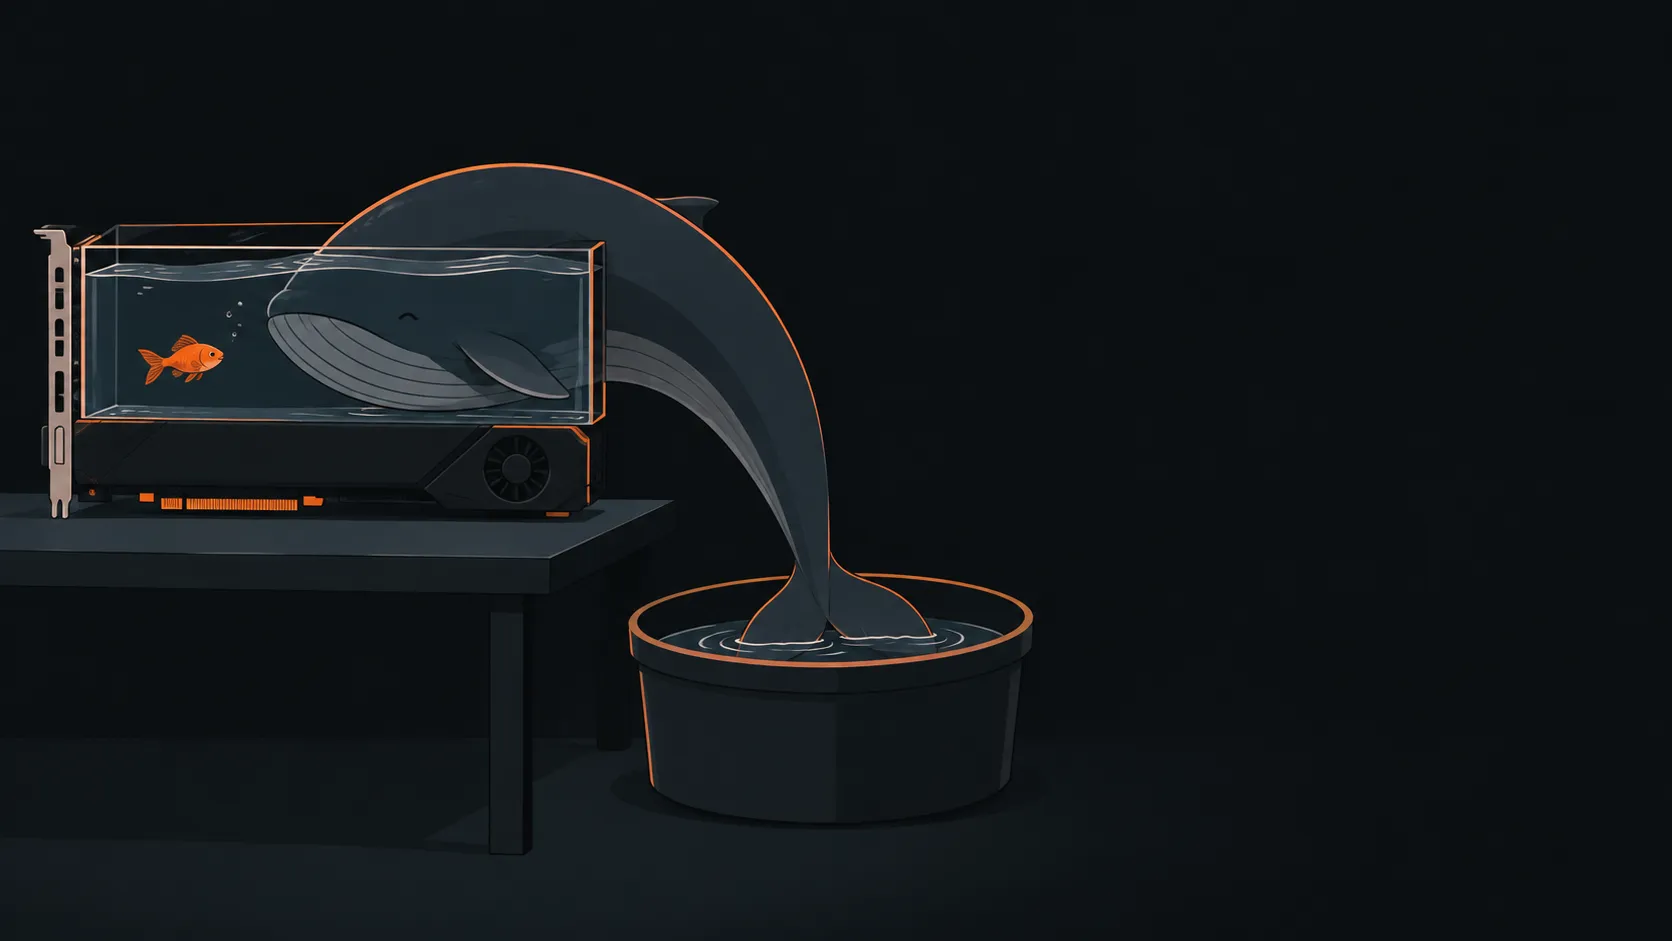
次の図は、ラッパーが重みの読み出しと変換器のあいだに入り、形だけを戻す様子です。
4次元で届けば assert は通り、変換は最後まで進みました。
ラッパー
llama.cpp を clone した場所を LLAMA_CPP に書き、適当な名前(ここでは wrapper.py)で保存します。
import runpy, sys
LLAMA_CPP = "/path/to/llama.cpp"   # llama.cpp を clone した場所
sys.path.insert(0, LLAMA_CPP)
from conversion import gpt_oss
_base = gpt_oss.GptOssModel.get_tensors
def _get_tensors(self):
    for name, t in _base(self):
        if name.endswith("_blocks") and len(t.shape) == 3:
            t = t.reshape(t.shape[0], t.shape[1], t.shape[2] // 16, 16)
        yield name, t
gpt_oss.GptOssModel.get_tensors = _get_tensors
sys.argv = [f"{LLAMA_CPP}/convert_hf_to_gguf.py", *sys.argv[1:]]
runpy.run_path(f"{LLAMA_CPP}/convert_hf_to_gguf.py", run_name="__main__")
やっていることは3つです。
- llama.cpp の変換器の gpt-oss 用の部分(
conversion.gpt_oss)を読み込み、GptOssModel.get_tensorsを差し替える - 差し替えた
get_tensorsは、名前が_blocksで終わり、しかも3次元のテンソルだけ、最後の次元を(1440/16, 16)に reshape して渡す。ほかのテンソルには手を付けない - 受け取った引数をそのまま
convert_hf_to_gguf.pyに渡し、runpyでスクリプトとして走らせる
呼び方は、変換器を直に呼ぶときと同じ引数です。
python wrapper.py "$SNAPSHOT" \
  --outtype auto --outfile GPT-OSS-Swallow-120B-RL-v0.1-MXFP4_MOE.gguf
python は変換用の venv の物、$SNAPSHOT はダウンロードした重みの置き場です。変換は 4 分 58 秒・RSS 4.9 GiB で終わり、専門家が MXFP4、ほかが bf16 の 61.3 GB(57 GiB)の GGUF ができました。
確かめ方
できた GGUF を llama-server で --n-cpu-moe 30 にして起こすと、VRAM 20 GB の Radeon RX 7900 XT で、VRAM 15.6 GB・生成 7.9 トークン/秒で動きました。
中身の確かめは1問です。「日本の首都と有名な電波塔を1文で」と聞くと、「日本の首都は東京で、そこにある有名な電波塔は東京タワーです。」と返りました。
確かめていないこと
- 当時の assert のトレースバックの全文(残っているのは assert の行と関数名だけです)
- llama.cpp の新しい版で、この3次元の形にそのまま対応したかどうか
- 長い文章で、元の gpt-oss の GGUF と出力を突き合わせること(確かめたのは上の1問だけです)
おわりに
同じ assert で止まったら、ブロックが3次元で届いていないかを見てください。並びが同じなら、llama.cpp を書き換えずに、読み出しのときに形を戻すだけで変換できました。
※ llama.cpp の変換器の振る舞いとモデルの配布物の形は執筆時点の情報で、いまは変わっている可能性があります。